🌐 El almacenamiento de datos, un costo oculto en la infraestructura de IA
La factura oculta de l'emmagatzematge de la IA: què deixa enrere la inferència
Quan es pensa en els costos de la intel·ligència artificial (IA), la majoria dels executius imaginen unitats de processament gràfic (GPUs) i el consum energètic que comporten. No obstant això, un aspecte crucial sovint passat per alt és el cost de l'emmagatzematge de dades. Què passa amb les dades després que un model respon? Gran part de les dades generades, des de milers de milions de sol·licituds diàries fins a imatges i vídeos, necessiten ser emmagatzemades, cosa que representa un desafiament significatiu per a la planificació de la infraestructura d'IA.
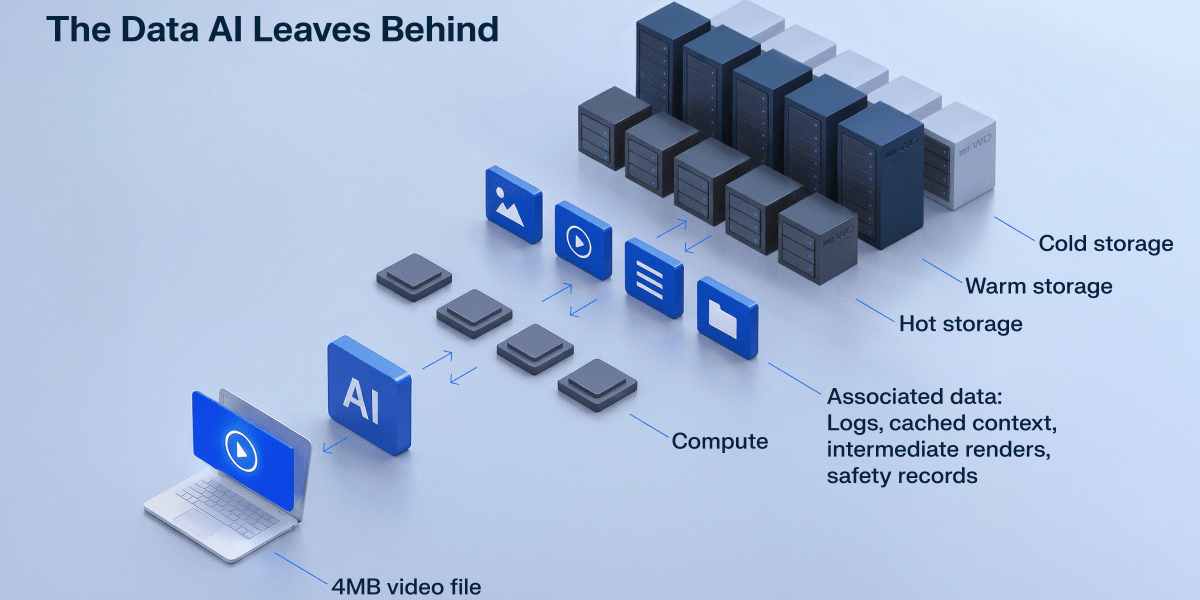
Tradicionalment, les converses sobre infraestructura d'IA s'han centrat en el procés intensiu d'entrenament de models. L'entrenament és finit: comença, consumeix recursos de còmput i acaba. Però la inferència, que ocorre cada vegada que un model respon a una sol·licitud, és contínua i deixa una empremta de dades que no desapareix. Per exemple, WD ha trobat que un clip de vídeo de 8 segons genera més de 500MB de dades associades en el backend, un augment de 130 vegades sobre la mida del fitxer que veu l'usuari.
La demanda d'inferència d'IA està creixent ràpidament. McKinsey projecta un creixement anual compost del 35% fins al 2030, en comparació amb el 22% per a l'entrenament, representant més del 40% de la demanda total de centres de dades per a finals de la dècada. Un informe global patrocinat per WD i IDC va trobar que gairebé el 95% dels enquestats van reportar un augment en el volum de dades a causa de la IA generativa en els darrers 12 mesos.
Per als CFOs o CIOs, això significa que la despesa en infraestructura d'IA pot estar massa enfocada en el còmput. Un model que espera mentre es carreguen les dades costa tant com un que espera per una GPU. L'estratègia d'emmagatzematge ha de considerar la capacitat escalable econòmicament, dissenyada per a tot el cicle de vida de les dades d'IA, equilibrant el rendiment amb la capacitat, el poder, la fiabilitat i el cost total de propietat.
AI’s hidden storage bill: What inference leaves behind
Cuando se piensa en los costos de la inteligencia artificial (IA), la mayoría de los ejecutivos imaginan unidades de procesamiento gráfico (GPUs) y el consumo energético que conllevan. Sin embargo, un aspecto crucial a menudo pasado por alto es el costo del almacenamiento de datos. ¿Qué sucede con los datos después de que un modelo responde? Gran parte de los datos generados, desde miles de millones de solicitudes diarias hasta imágenes y videos, necesitan ser almacenados, lo que representa un desafío significativo para la planificación de la infraestructura de IA.
Tradicionalmente, las conversaciones sobre infraestructura de IA se han centrado en el proceso intensivo de entrenamiento de modelos. El entrenamiento es finito: comienza, consume recursos de cómputo y termina. Pero la inferencia, que ocurre cada vez que un modelo responde a una solicitud, es continua y deja una huella de datos que no desaparece. Por ejemplo, WD ha encontrado que un clip de video de 8 segundos genera más de 500MB de datos asociados en el backend, un aumento de 130 veces sobre el tamaño del archivo que ve el usuario.
La demanda de inferencia de IA está creciendo rápidamente. McKinsey proyecta un crecimiento anual compuesto del 35% hasta 2030, en comparación con el 22% para el entrenamiento, representando más del 40% de la demanda total de centros de datos para finales de la década. Un informe global patrocinado por WD e IDC encontró que casi el 95% de los encuestados reportaron un aumento en el volumen de datos debido a la IA generativa en los últimos 12 meses.
Para los CFOs o CIOs, esto significa que el gasto en infraestructura de IA puede estar demasiado enfocado en el cómputo. Un modelo que espera mientras se cargan los datos cuesta tanto como uno que espera por una GPU. La estrategia de almacenamiento debe considerar la capacidad escalable económicamente, diseñada para todo el ciclo de vida de los datos de IA, equilibrando el rendimiento con la capacidad, el poder, la fiabilidad y el costo total de propiedad.
AI’s hidden storage bill: What inference leaves behind
When thinking about the costs of artificial intelligence (AI), most executives imagine graphics processing units (GPUs) and the energy consumption they entail. However, a crucial aspect often overlooked is the cost of data storage. What happens to the data after a model responds? Much of the generated data, from billions of daily requests to images and videos, needs to be stored, representing a significant challenge for AI infrastructure planning.
Traditionally, discussions about AI infrastructure have focused on the intensive process of model training. Training is finite: it begins, consumes computing resources, and ends. But inference, which occurs every time a model responds to a request, is continuous and leaves a data footprint that does not disappear. For example, WD has found that an 8-second video clip generates more than 500MB of associated data in the backend, an increase of 130 times over the file size seen by the user.
The demand for AI inference is growing rapidly. McKinsey projects a compound annual growth of 35% until 2030, compared to 22% for training, representing more than 40% of the total demand for data centres by the end of the decade. A global report sponsored by WD and IDC found that nearly 95% of respondents reported an increase in data volume due to generative AI in the last 12 months.
For CFOs or CIOs, this means that spending on AI infrastructure may be too focused on computing. A model waiting while data is loaded costs as much as one waiting for a GPU. The storage strategy must consider economically scalable capacity, designed for the entire AI data lifecycle, balancing performance with capacity, power, reliability, and total cost of ownership.
¿Te ha interesado esta noticia?
Recibe cada mañana el resumen de IA y sociedad directo en tu email.
Suscríbete gratis →